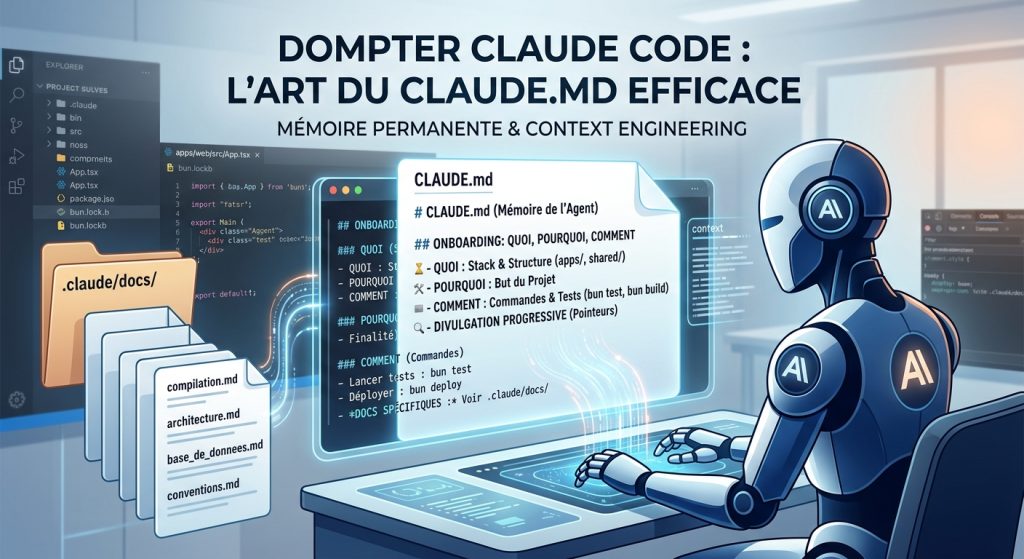
Injecté automatiquement à chaque début de session,
CLAUDE.mdconstitue la mémoire permanente de votre agent. Rédiger un fichier sobre et ciblé permet d’orienter le modèle sans saturer son contexte ni dégrader ses réponses. Découvrez les bonnes pratiques d’ingénierie de contexte pour transformer ce document en votre meilleur levier de productivité.
- 1 1. Un LLM n’a aucune mémoire de ton projet
- 2 2. Transformer CLAUDE.md en kit de bienvenue
- 3 3. Quand l’agent fait la sourde oreille : le piège des instructions superflues
- 4 4. Les règles du context engineering : la sobriété avant tout
- 5 5. Réduire la voilure et cibler le contexte utile
- 6 6. L’architecture modulaire par divulgation progressive
- 7 7. Ne délègue pas à l’IA ce qu’un linter fait en 10 ms
- 8 8. Fuis le bouton magique : pourquoi il faut bannir /init
- 9 En résumé : la checklist d’un fichier efficace
1. Un LLM n’a aucune mémoire de ton projet
Les modèles de langage sont des fonctions récursives sans état (stateless). Leurs poids sont figés lors de l’entraînement : ils n’apprennent absolument rien au fil de tes sessions de travail. Tout ce qu’un modèle comprend de ton application provient exclusivement des tokens injectés dans la fenêtre de contexte au moment où tu lui parles.
Les orchestrateurs d’agents comme Claude Code reposent donc sur une gestion explicite de cette mémoire. Le fichier CLAUDE.md (ou AGENTS.md) est l’unique document automatiquement injecté au départ de chaque interaction.
Ce fonctionnement implique trois réalités :
- L’agent démarre chaque nouvelle session en étant totalement amnésique.
- Tu dois lui transmettre tout le contexte critique du projet à chaque lancement.
CLAUDE.mdconstitue la passerelle idéale pour remplir ce rôle.
2. Transformer CLAUDE.md en kit de bienvenue
Pour sortir l’agent de son amnésie initiale, structure ton fichier d’accueil autour de trois piliers fondamentaux :
- Le QUOI : cartographie le projet. Décris la stack technique, les dépendances principales et l’architecture des dossiers. C’est capital dans un monorepo : précise quels répertoires contiennent les applications, les bibliothèques partagées et le rôle de chaque brique.
- Le POURQUOI : explique la finalité de l’application et la fonction métier des différentes parties du dépôt.
- Le COMMENT : donne-lui les instructions opérationnelles. Utilises-tu
bunplutôt quenpm? Comment l’agent doit-il valider ses modifications ? Indique précisément les commandes pour lancer les tests, le typecheck et le build.
Garde une règle en tête : ne surcharge pas le fichier avec chaque sous-commande possible. Tu obtiendrais l’effet inverse de celui recherché.
3. Quand l’agent fait la sourde oreille : le piège des instructions superflues
Il arrive régulièrement que Claude semble ignorer des consignes pourtant inscrites dans ton CLAUDE.md.
Tu peux le vérifier toi-même en interceptant les requêtes du CLI Claude Code vers l’API Anthropic (via un proxy de journalisation configuré sur ANTHROPIC_BASE_URL). Claude Code injecte systématiquement ce rappel système aux côtés de ton fichier :
<code><system-reminder>      IMPORTANT: this context may or may not be relevant to your tasks.
      You should not respond to this context unless it is highly relevant to your task.
</system-reminder>
En clair, l’agent mettra de côté les instructions de ton CLAUDE.md s’il estime qu’elles n’ont pas de lien direct avec le problème immédiat à résoudre. Plus ton fichier accumule des règles spécifiques ou secondaires, plus l’agent risque de filtrer l’ensemble du document.
Pourquoi ce comportement a-t-il été implémenté ? Beaucoup de développeurs transforment leur CLAUDE.md en un registre de correctifs de dernière minute (hotfixes de comportement) pour corriger des erreurs ponctuelles. L’équipe d’Anthropic a probablement constaté qu’autoriser le modèle à ignorer ce bruit de fond améliorait nettement ses performances globales.
4. Les règles du context engineering : la sobriété avant tout
Rédiger un bon fichier réclame d’appliquer quelques principes éprouvés d’ingénierie de contexte.
La règle du « Less is More »
Il est tentant de consigner toutes les conventions d’écriture et toutes les commandes de ton projet dans un seul fichier. C’est une erreur.
Les études sur le comportement des modèles récents mettent en avant plusieurs constats :
- Un plafond d’instructions : les grands modèles capables de raisonnement (thinking models) suivent de manière fiable environ 150 à 200 instructions distinctes. Les modèles plus modestes ou sans mode de raisonnement en gèrent beaucoup moins.
- Une dégradation asymétrique : la perte d’attention des petits modèles est exponentielle au fur et à mesure que les consignes s’accumulent. Chez les grands modèles, cette décomposition reste linéaire. C’est pour cette raison qu’il faut éviter les petits modèles pour les tâches complexes à plusieurs étapes.
- L’effet de bordure : les LLM privilégient les instructions situées aux extrémités du prompt (tout au début avec le fichier système et
CLAUDE.md, et tout à la fin avec le dernier message utilisateur). - L’érosion uniforme : quand le volume d’instructions devient trop important, le modèle ne néglige pas seulement les dernières lignes : il commence à ignorer l’ensemble du fichier de façon homogène.
Le prompt système natif de Claude Code consomme à lui seul environ 50 instructions. Cela représente déjà près du tiers de sa capacité de rétention optimale — avant même d’ajouter tes propres règles, tes plugins ou tes messages. Ton CLAUDE.md doit donc se limiter aux consignes strictement universelles.
5. Réduire la voilure et cibler le contexte utile
Un LLM donne le meilleur de lui-même lorsque son contexte est rempli d’éléments directement utiles à la tâche (extraits de code cibles, retours d’outils, exemples concrets) plutôt que de consignes théoriques.
Tout ce qui figure dans CLAUDE.md étant présent en permanence, supprime les règles spécialisées. Une consigne sur la migration des schémas de base de données n’a rien à faire dans le contexte permanent si tu travailles sur un composant d’interface utilisateur.
Sur la longueur, la sobriété prime : même s’il n’existe pas de limite officielle fixée par Anthropic, la recommandation générale est de rester sous la barre des 300 lignes (et idéalement bien en dessous). Le fichier CLAUDE.md à la racine du projet chez HumanLayer fait par exemple moins de 60 lignes.
6. L’architecture modulaire par divulgation progressive
Comment transmettre un projet complexe sans asphyxier le contexte permanent ? En appliquant le principe de Divulgation Progressive (Progressive Disclosure).
Au lieu d’inscrire tous les détails dans CLAUDE.md, découpe tes connaissances dans des fichiers isolés aux noms explicites, rangés dans un dossier dédié :
<code>.claude/docs/
  ├─ compilation-et-build.md
  ├─ protocole-de-test.md
  ├─ architecture-microservices.md
  ├─ schema-base-de-donnees.md
  └─ regles-metier-et-flux.md
Dans ton fichier CLAUDE.md principal, résume simplement le rôle de chaque document et demande à l’agent d’aller lire le fichier pertinent uniquement lorsque sa tâche l’exige (ou de te demander la permission avant de le charger).
Conseil : ne copie-colle pas d’exemples de code dans ces fichiers sous peine de les voir rapidement devenir obsolètes. Utilise plutôt des pointeurs précis au format chemin/du/fichier:numéro_de_ligne.
7. Ne délègue pas à l’IA ce qu’un linter fait en 10 ms
Inscrire un guide de style de 100 lignes dans CLAUDE.md est un mauvais réflexe. Les modèles de langage sont extrêmement lents et coûteux par rapport à des outils d’analyse statique déterministes.
Répéter des consignes de formatage dégrade inutilement l’attention de l’agent et gaspille tes tokens.
Les LLM apprennent par l’exemple (in-context learning). Si ta codebase est propre et cohérente, l’agent imitera naturellement les conventions existantes après quelques recherches dans le dépôt.
Si tu souhaites garantir un respect strict des règles de style :
- Configure un Stop Hook dans Claude Code : à chaque fin de tâche, le hook déclenche automatiquement ton linter/formatteur (comme Biome ou ESLint) et renvoie les erreurs directement à l’agent pour qu’il les corrige.
- Crée une Commande Slash sur mesure regroupant tes directives de style pour qu’elle analyse uniquement le diff Git (
git status/git diff) sur demande.
8. Fuis le bouton magique : pourquoi il faut bannir /init
La plupart des environnements pour agents proposent une commande d’initialisation automatique (/init) pour fabriquer un fichier CLAUDE.md à partir d’un scan rapide de ton projet.
CLAUDE.md est le point d’appui avec le plus grand effet de levier sur tes sessions :
- Une erreur dans une ligne de code crée un bug localisé.
- Une erreur dans un plan de développement génère des dizaines de lignes de code défectueuses.
- Une erreur dans le fichier
CLAUDE.mdbiaise l’ensemble des phases de réflexion, des plans d’action et des lignes de code produits lors de chaque session.
Prends le temps de rédiger et d’ajuster chaque ligne de ce fichier à la main.
En résumé : la checklist d’un fichier efficace
- Rôle principal :
CLAUDE.mdest ton document d’intégration (QUOI, POURQUOI, COMMENT). - Priorité à la sobriété : limite le nombre d’instructions au strict minimum universel.
- Pertinence permanente : ne conserve que ce qui s’applique à 100 % de tes tâches.
- Divulgation progressive : déporte la documentation spécifique dans des fichiers secondaires ciblés.
- Outillage déterministe : laisse le formatage aux linters automatisés via les hooks et commandes slash.
- Rédaction manuelle : n’auto-génère pas ce fichier, contrôle chaque consigne.
Pour aller plus loin, Anthropic propose des documentations bien faites sur le prompt engineering: